Перед каждым релизом команда садится проверять руками одно и то же: вход в кабинет, оформление заказа, выгрузку в 1С, оплату, письмо клиенту. Полтора дня тестировщика в спокойный месяц. А на проде всё равно всплывает то, что не догадались открыть в пятой по счёту форме. Ниже наша практика: как устроены автотесты на Playwright (фреймворк для тестирования веб-интерфейсов), какие сценарии мы покрываем первыми, сколько это стоит и через сколько релизов окупается.
Сколько на самом деле стоит регресс руками
Возьмём типовой B2B-портал с личным кабинетом и обменом с учётной системой. Полный ручной регресс перед релизом - это 10-14 часов работы тестировщика. По рынку (срез: июль 2026) час специалиста на аутсорсе стоит 2 000-3 500 рублей, в штате выходит сопоставимо с учётом налогов и простоев. Два релиза в месяц - и вы платите 50-80 тысяч рублей ежемесячно за то, чтобы человек в сотый раз прокликал одну и ту же форму заказа.
Есть и вторая часть счёта, менее заметная. Ручной регресс всегда неполный: человек устаёт, а редкие сценарии вроде отмены заказа с частичным возвратом откладывает на потом. Часть багов доезжает до прода, и дальше работает известное правило: чем позже найден дефект, тем дороже он обходится. Ошибка на код-ревью стоит десяти минут разработчика. Она же на проде стоит звонков от клиентов, хотфикса в пятницу вечером и отката, а иногда и прямых потерь, если полдня не оформлялись заказы.
Набор автотестов на тот же сценарий прогоняется за 10-20 минут, запускается на каждое изменение и не устаёт.
Юнит, интеграционные и e2e-тесты: что чем ловится
Юнит-тест проверяет одну функцию в отрыве от мира: посчитала ли скидка правильную сумму. Интеграционный проверяет стык: сходил ли сервис заказов в базу и в API учётной системы, разобрал ли ответ. E2e (end-to-end) проходит весь путь пользователя через браузер, от входа в кабинет до статуса оформленного заказа.
| Уровень теста | Что ловит | Скорость прогона | Стоимость поддержки |
|---|---|---|---|
| Юнит | ошибки в логике одной функции | миллисекунды | низкая |
| Интеграционный | сломанный стык между модулями и внешними системами | секунды | средняя |
| E2e через браузер | сценарий целиком: интерфейс, бэкенд, интеграции | десятки секунд | высокая |
| Ручной exploratory | то, чего никто не предусмотрел | часы | человеческая |
Классическая пирамида тестирования советует держать много быстрых юнит-тестов внизу и совсем немного медленных e2e наверху. В заказной разработке мы регулярно от неё отступаем: в проектах с интеграциями (1С, платёжный шлюз, служба доставки, телефония) большинство болезненных багов живёт на стыках. Идеально протестированные по отдельности модули прекрасно ломаются вместе, поэтому середина нашей пирамиды толще, чем в учебнике.
Почему мы выбрали Playwright для e2e и UI-тестирования
Playwright - открытый фреймворк от Microsoft, вокруг которого собралась большая часть новых проектов автоматизации.
Что оказалось важным:
- Автоожидания. Главная боль старых наборов - таймауты руками. Разработчик пишет ожидание в три секунды, на загруженном CI-агенте элемент появляется за четыре, тест падает без причины. Playwright перед каждым действием сам проверяет, что элемент есть в DOM, видим, не перекрыт и готов принять клик. Это убирает основной источник нестабильности.
- Трассировка. Упавший тест в CI обычно бесполезен: скриншот и стек. Playwright пишет трассировку прогона со снимками DOM на каждом шаге, сетевыми запросами и консолью. Открываешь её локально и прокручиваешь падение назад по шагам, разбор сокращается с часа до нескольких минут.
- Три движка и параллельность. Chromium, Firefox и WebKit запускаются одним и тем же кодом, так что верстальные сюрпризы Safari вылезают на CI, а не у клиента. Тесты раскладываются по воркерам из коробки, отдельная инфраструктура вроде Selenium Grid не нужна: изоляция достигается контекстами браузера.
Playwright или Selenium, а может Cypress
Сравнивать имеет смысл по задачам. Selenium никуда не делся и в ряде ситуаций остаётся правильным выбором. По опросам QA-сообщества Playwright в 2026 году обошёл его по доле использования в новых проектах, но у зрелых команд с большим наследием картина другая.
| Инструмент | Класс | Сильная сторона | Где живут код и данные | Цена «от» (июль 2026) | Кому подходит |
|---|---|---|---|---|---|
| Playwright | фреймворк e2e и UI-тестов | автоожидания, трассировка, 3 движка, параллельность | ваш репозиторий и CI | бесплатно, open source | новым проектам, командам на JS/TS и Python |
| Selenium | фреймворк UI-тестов, стандарт WebDriver | языки на выбор (Java, C#, Python, Ruby), старые браузеры | ваш репозиторий и CI | бесплатно, open source | большим наборам на Java, корпоративным ландшафтам |
| Cypress | фреймворк фронтенд-тестов | отладка в браузере, компонентные тесты | код у вас, облачные отчёты у вендора | бесплатно; Cypress Cloud от 67 $/мес | фронтенд-командам на JS |
| Allure Report | отчёты о прогонах | наглядные отчёты, история, вложения | ваш CI | бесплатно, open source | всем, кому отчёт показывают заказчику |
| Allure TestOps | управление тестированием | связка ручных и авторских тестов, аналитика | сервер вендора или свой | от 39 $ за пользователя в месяц | командам от 5 QA с большим набором |
Если тесты должны пережить смену подрядчика, код обязан лежать в вашем репозитории и запускаться в вашем CI, а не внутри чужой платформы. Язык и фреймворк вторичны и решаются компетенциями команды. Мы берём Playwright по умолчанию, но работающие наборы на Selenium не трогаем.
Как мы строим тесты у себя
Набор тестов - такой же код, как продуктовый, и без архитектуры он захламляется так же быстро.
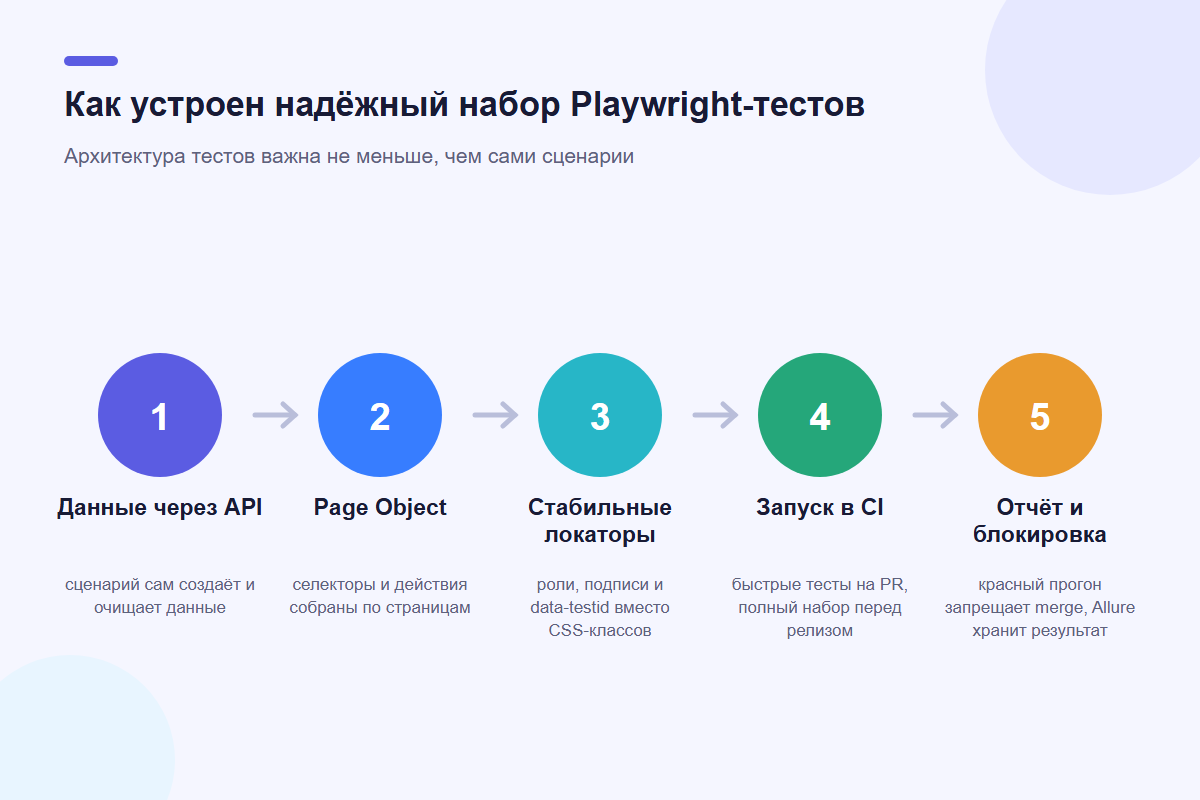
Основа - Page Object: каждая страница описывается отдельным классом, селекторы и действия живут там, а не в тексте теста. Когда дизайнер переименует кнопку оформления, правка будет в одном файле. Цепляемся при этом за роли и подписи, которые видит пользователь, либо за атрибуты data-testid. Привязка к сгенерированным CSS-классам гарантирует развал набора на первом же рефакторинге вёрстки.
Каждый сценарий готовит данные сам: создаёт контрагента, товар, заявку через API, а не через интерфейс, и убирает за собой. Общая база на всех означает тесты, которые падают по очереди из-за чужих действий. Авторизация выносится в фикстуру.
Быстрые тесты идут на каждый пул-реквест, полный набор - ночью и перед релизом. Красный прогон блокирует мерж, иначе через месяц на падения перестают смотреть.
Что автоматизировать первым
Полное покрытие - ловушка: половина набора опишет редкие сценарии, а поддерживать придётся целиком. Мы начинаем с критичного пути, где поломка означает потерю денег или репутации:
- вход в систему и восстановление доступа;
- оформление заказа от начала до конца, включая письмо и статус;
- оплата и обработка ответа платёжного шлюза;
- обмен с 1С: выгрузка заказа, приём остатков и цен, статусы отгрузки;
- права доступа: менеджер не видит чужих клиентов, клиент не видит чужих документов;
- ключевые отчёты и выгрузки, на которые смотрит руководство.
10-15 таких сценариев хватает, чтобы снять с ручного регресса основную нагрузку. Не стоит автоматизировать точное расположение элементов, редкие административные операции раз в квартал, экраны в активной переделке. И если сценарий закрывается интеграционным тестом без браузера, так и делаем: он в разы быстрее.
Расскажите о задаче - бесплатно подготовим работающий прототип.
Нестабильные тесты, или почему набор перестают запускать
Флаки-тест - тот, который на одном и том же коде то проходит, то падает. Один такой терпимо. Десяток - и команда привыкает перезапускать прогон не глядя, после чего набор теряет смысл.
Автоожидания убирают самую частую причину, остальное лечится дисциплиной: не завязываться на порядок выполнения тестов, не переиспользовать данные между сценариями, подменять заглушками нестабильные внешние сервисы (чужая песочница платёжного шлюза падает сама по себе, и это не ваш баг), ждать явного события от фоновых задач.
Сколько стоит и когда окупается
Порядок цифр по нашей практике. Инфраструктура (проект, CI, отчёты, фикстуры и авторизация) - 20-40 часов. Один продуманный e2e-сценарий с подготовкой данных - от 4 до 12 часов. Базовый набор на критичный путь - 80-150 часов, то есть примерно от 250 тысяч рублей по рыночным ставкам. Поддержка обходится в 10-15% от объёма набора в месяц.
При ручном регрессе на 60 тысяч рублей в месяц вложение возвращается за 5-7 релизных циклов. Дальше начинается то, что деньгами измеряется хуже: выкатывать можно чаще, потому что проверка занимает 20 минут вместо целого дня, и старый код можно править без страха.
Автотесты не заменяют тестировщиков, они забирают механическую часть - повторный прогон одних и тех же путей.
Остальное остаётся человеку: придумать сценарии, исследовать продукт руками, найти то, о чём никто не подумал. Робот отвечает на вопрос «работает ли то, что мы описали». Вопрос «а то ли мы описали» решает человек.
Чек-лист: пора внедрять автотесты
- Регресс перед релизом занимает больше рабочего дня.
- Релизы стали реже, потому что каждый страшно выкатывать.
- Один и тот же баг возвращался на прод дважды.
- В системе есть интеграции с внешними сервисами и учётной системой.
- Продукт будет жить и меняться дольше года.
- Есть CI, куда можно повесить прогон, или его несложно поднять.
Три пункта и больше - автотесты окупятся. Один-два - скорее рано: если интерфейс переделывается каждую неделю, тесты будут переписываться быстрее, чем приносить пользу.
Главное
- Автотесты экономят на регрессе и защищают от повторных багов, а не ставят галочку о зрелости процесса.
- Playwright тесты сильны автоожиданиями, трассировкой и параллельным запуском без отдельной инфраструктуры; живые наборы на Selenium переписывать не нужно.
- Начинать с критичного пути: вход, заказ, оплата, обмен с 1С, права доступа. Хватает 10-15 сценариев.
- Код тестов должен лежать в вашем репозитории и запускаться в вашем CI.
- Базовый набор стоит от 250 тысяч рублей и окупается за 5-7 релизных циклов при регрессе от 10 часов.
FAQ
Чем Playwright лучше Selenium? Не лучше в абсолютном смысле, а удобнее для новых проектов: автоожидания вместо ручных таймаутов, встроенная трассировка, параллельный запуск без Selenium Grid, поддержка WebKit. Selenium выигрывает широтой языков, и если у вас живой набор на Java, переписывать его незачем.
Как быстро прогоняются автотесты на Playwright? Сценарий из десятка шагов проходит за 10-40 секунд. Набор из 15 сценариев на четырёх воркерах укладывается в 10-20 минут, поэтому его можно гонять на каждый пул-реквест.
Нужны ли автотесты небольшому проекту? Лендингу или разовому MVP на три месяца - скорее нет. Как только появляются деньги в процессе, личные кабинеты и обмен с учётной системой, цена одного сбоя на проде превышает стоимость набора.
Кто пишет тесты: разработчики или тестировщики? Автоматизатор в связке с разработчиком: первый отвечает за сценарии и поддержку набора, второй - за тестовые атрибуты в вёрстке и точки входа через API. Кстати, проверки интеграций и подготовку данных Playwright умеет делать HTTP-запросами, без браузера: так быстрее и стабильнее.
Если нужна помощь
Мы делаем заказную разработку и отвечаем за качество того, что строим: автотесты, DevOps-инфраструктура, техническая поддержка 24/7. Если регресс превратился в ежемесячную статью расходов, посмотрим, какие сценарии автоматизировать первыми, и посчитаем окупаемость на ваших цифрах.
Обсудить задачу: mail@drsofter.ru, Telegram @drsofter или форма на drsofter.ru.
15+ лет делаю веб-сервисы и enterprise-платформы: от MVP до систем с миллионной аудиторией. Больше десяти лет руковожу разработкой, строю команды и слежу, чтобы технологии приносили деньги, а не только красиво выглядели в архитектурных схемах. Сейчас много работаю с LLM и ИИ-агентами в бизнес-процессах.